어도비가 ‘Adobe MAX 2026’에서 AI 기반의 영상, 음성, 이미지 편집 기술을 선보였다. 여러 컷을 넘나드는 편집, 실시간 영상 연출, 음성 추출 및 변형, 직관적인 이미지 조작 등 창작의 새로운 가능성을 제시했다.
💡 핵심 요약
- 어도비 MAX 2026 Sneaks에서 AI 기반의 10개 첨단 연구 프로젝트 공개
- 영상 편집: 여러 컷에 걸친 일관된 편집, 실시간 연출, 가상 캐릭터 제작 등
- 음성/이미지/디자인: 음성 추출 및 변형, 이미지 구조 이해 기반 직관적 편집, 벡터 디자인 연동 등
- Adobe Labs Playground 통해 일부 기술 체험 및 피드백 제공
어도비는 미국 마이애미 비치에서 열린 ‘Adobe MAX 2026’에서 연구 개발 중인 첨단 기술을 소개하는 연례 세션 ‘Sneaks’를 진행했다. 이번에는 영상, 음성, 이미지, 디자인 등 다양한 분야에서 10개의 연구 프로젝트를 선보였다. 여러 컷에 걸친 영상 편집, 영상의 실시간 연출, 음성 추출 및 변형, 이미지를 이해하는 직관적인 편집 조작 등 창작 제작의 새로운 가능성을 제시했다.
‘Adobe MAX Sneaks’는 Adobe Research를 비롯한 연구 개발팀이 미래의 창작 도구로 이어질 기술을 미리 공개하는 세션이다. 올해는 전직 프로 미식축구 선수이자 배우인 테리 크루즈(Terry Crews)가 사회를 맡아 연구 단계에 있는 10개의 프로젝트를 소개했다.
이번 발표에서 공통적으로 나타난 방향성은 AI가 이미지나 영상의 내용, 조작 의도를 이해하여 창작자가 필요한 변경을 더욱 직접적으로 실행할 수 있도록 하는 것이었다. 기존에는 여러 단계를 거쳐야 했던 작업을 컷을 넘나드는 조작, 제스처, 자연어 지시 등으로 대체하는 연구가 공개되었다.
더불어 올해는 무대 발표에 그치지 않고, 일부 연구 성과를 웹상에서 체험할 수 있는 ‘Adobe Labs Playground’도 공개되었다. 개발 초기 단계의 기술을 창작자가 직접 사용해보고 피드백을 전달할 수 있는 새로운 시도다.
여러 컷 편집부터 실시간 연출까지, 영상 제작의 가능성 확장
영상 분야에서는 여러 컷에 걸친 일관된 편집, 가상 캐릭터 제작, 재생 중인 영상에 대한 연출 지시, 생성 영상 내 이벤트 발생 시점 제어 등 4개의 프로젝트가 소개되었다. 이들은 개별 클립에 순차적으로 조작을 가하는 것을 넘어, 영상 전체의 내용과 시간의 흐름을 이해하는 편집을 목표로 하는 연구다.
Project Scene Sweep

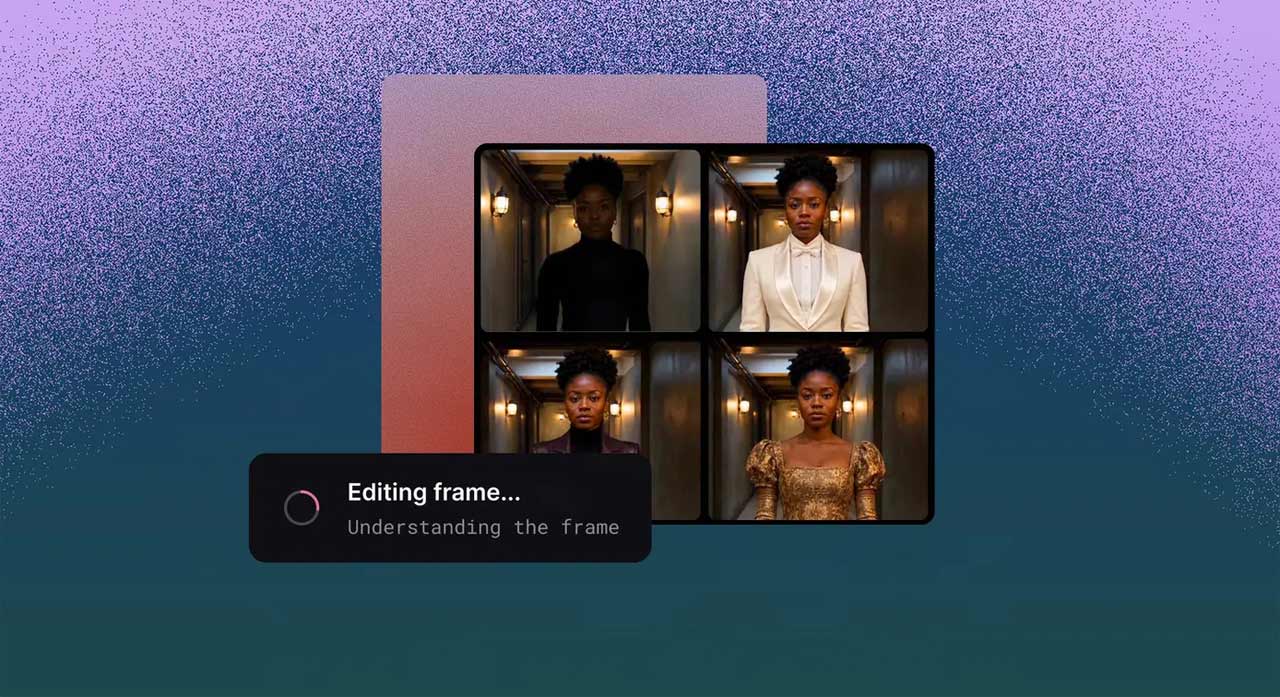
여러 컷으로 구성된 영상에서 동일한 인물이나 배경에 변경을 가할 때, 각 클립마다 동일한 편집을 반복해야 하는 번거로움이 있었다. ‘Project Scene Sweep’은 영상 시퀀스 전체에 등장하는 인물, 로케이션, 장면을 이해하고 여러 컷과 카메라 앵글을 넘나들며 일관된 편집을 적용하는 기술이다.
예를 들어, 한 컷에서 결정한 편집 내용을 동일한 대상이 등장하는 다른 컷에도 반영할 수 있다. 창작자가 한 번 내린 판단을 장면 전체에 적용함으로써 컷별 조정 작업을 줄이고 편집의 일관성을 유지하는 것을 목표로 한다.
Project Screen Test

영상 편집 외에도 이야기를 구성하는 캐릭터 자체를 개발하는 연구도 공개되었다. ‘Project Screen Test’는 가상 캐릭터의 외형, 목소리, 성격을 설정하고, 해당 캐릭터와 자연어로 대화하며 인물상을 만들어가는 기술이다.
대화를 통해 캐릭터의 생각이나 반응을 탐색하고, 다른 장면에서 어떻게 행동할지 검토할 수 있다. 기존에는 텍스트나 설정 자료 중심으로 진행했던 캐릭터 개발을 대화형 제작 환경으로 확장하는 시도다.
Project Live Set
영상 제작의 또 다른 방향성으로 제시된 것은 장면을 재생하면서 연출 내용을 변경하는 ‘Project Live Set’이다. 이 기술은 영상 재생 중에 피사체를 변경하거나, 배경이 되는 환경을 바꾸거나, 카메라 시점을 전환하는 것이 가능하다.
기존 영상 편집에서는 변경 후 결과를 재생하여 확인하는 작업이 일반적이었지만, Project Live Set은 장면이 진행되는 도중에 연출을 지시하고 그 변화를 확인할 수 있는 제작 환경을 목표로 한다. 영상을 고정된 완성 소재로 취급하는 것이 아니라, 연출에 따라 변화하는 공간으로 조작하는 연구라고 할 수 있다.
Project On Cue
영상 내용뿐만 아니라 특정 사건이 발생하는 시점을 제어하는 연구가 ‘Project On Cue’다. 텍스트 프롬프트로 영상 생성 시, 무엇을 보여줄지는 지정할 수 있지만, 동작이나 빛의 변화를 발생시키는 정확한 시점 제어에는 어려움이 있었다.
Project On Cue에서는 영상 내 액션이나 빛의 깜빡임 등이 발생하는 시점을 편집 가능한 제어 신호로 지정할 수 있다. 제어 신호는 손으로 직접 그릴 수도 있고, 기존 영상이나 음악에서 추출할 수도 있다. 이를 통해 음악의 리듬에 맞춰 움직임을 발생시키거나, 특정 순간에 영상 연출을 추가하는 등 시간 축에 따른 생성 영상의 제어를 목표로 한다.
음성을 추출하여 영상에 맞춰 변형하는 새로운 사운드 제작
영상 제작과 밀접하게 관련된 음성 분야에서는 완성된 음성 믹스에서 필요한 소리를 추출하고, 그 특징과 시간적 변화를 조작하는 연구가 소개되었다. 여러 소리가 혼합된 소재에서 특정 소리를 추출하여 영상에 맞춰 조정할 수 있다면, 효과음 제작이나 믹싱의 자유도가 넓어질 것이다.
Project Sound Bender
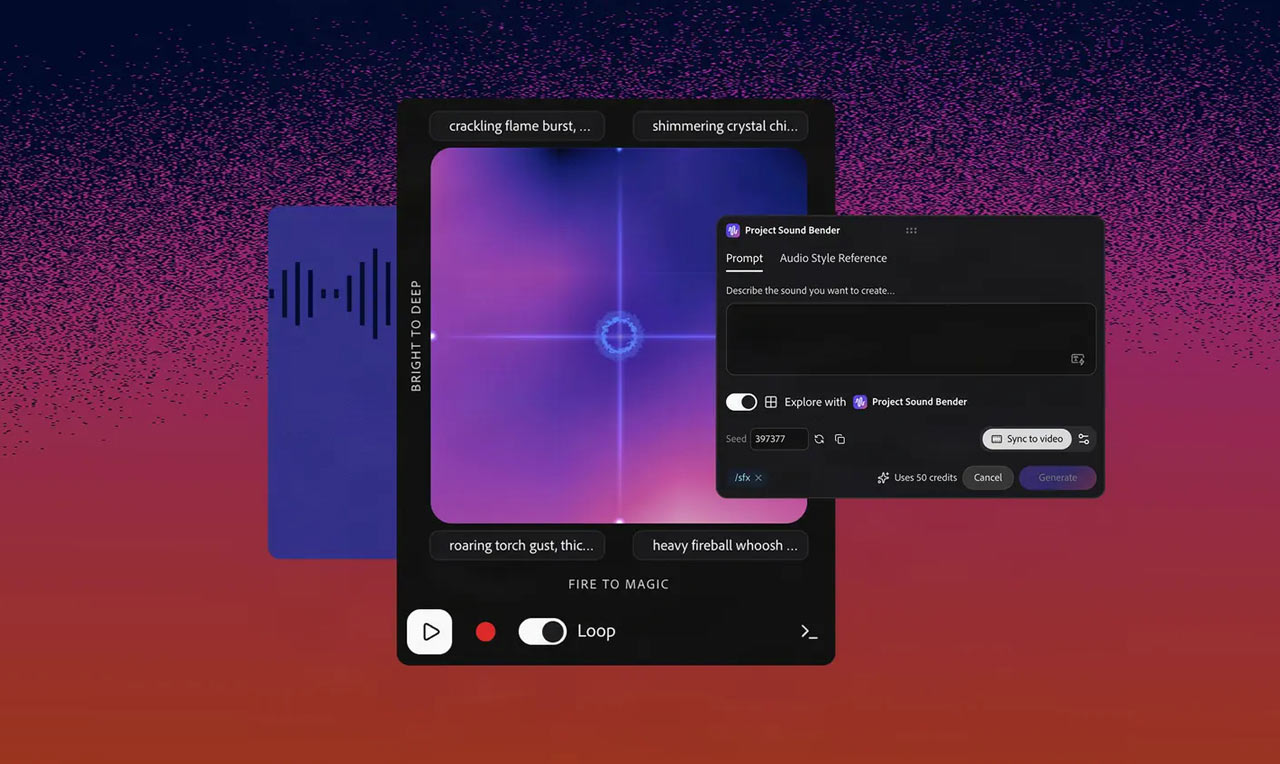
‘Project Sound Bender’는 완성된 음성 믹스에서 지정한 소리를 추출하고, 인터랙티브한 조작 화면에서 소리 특징을 변화시키는 기술이다. 창작자는 추출하고 싶은 소리를 텍스트로 설명함으로써 여러 소리가 혼합된 소재에서 원하는 소리를 얻을 수 있다. 더불어 추출한 소리의 특성을 실시간으로 변화시키며 다양한 변형을 시도할 수 있다.
소리 변화를 영상의 움직임이나 편집 시점에 맞추는 것도 예상되며, 화면상의 액션이나 장면 전환에 맞는 효과음 제작에 활용될 수 있다. 또한, 기존 소재에 원하는 소리가 없을 경우, 텍스트 설명을 통해 새로운 소리를 생성하고 인터랙티브한 조작으로 조정하는 것도 가능하다.
기존 음성 소재의 편집과 새로운 소리 생성을 동일한 제작 환경에서 다룸으로써 영상에 맞는 사운드 디자인을 보다 유연하게 진행하는 연구다.
이미지와 디자인을 이해하고 직접 조작할 수 있는 편집 환경으로
이미지·디자인 분야에서는 AI가 이미지의 내용과 구조를 이해하고, 창작자의 조작을 적절한 편집 결과로 연결하는 5개의 프로젝트가 공개되었다. 기존 이미지 편집에서는 목표 영역을 선택하고 색상이나 모양을 개별적으로 조정하는 조작이 필요했다. 이번 연구에서는 이미지 내의 객체와 공간적 관계를 AI가 이해하고, 그리기나 드래그 등 직관적인 조작으로 편집을 진행할 수 있도록 하는 방향성이 제시되었다.
Project Deep Brush

‘Project Deep Brush’는 AI가 이미지 내의 모양, 색상, 조명을 이해하고 이에 따라 그리기 내용을 변화시키는 브러시 기술이다. 예를 들어, 이미지 내에 있는 객체의 표면을 따라 브러시를 움직이면 대상의 모양에 맞춰 그리기가 적용된다. 객체의 색상을 변경할 때도 원본 이미지의 자연스러운 음영을 유지하면서 조정할 수 있다.
더불어 이미지 내에 직접 빛을 그려 넣는 듯한 조작도 지원한다. 단순히 지정한 색상을 픽셀에 칠하는 것이 아니라, 대상의 입체감과 조명 조건을 고려하여 편집할 수 있다는 점이 특징이다.
Project Sight Span
‘Project Sight Span’은 한 장의 이미지를 시점을 이동하며 탐색할 수 있는 공간으로 변환하는 연구다. 일반적인 사진이나 일러스트에서는 촬영 또는 그려진 시점에서만 장면을 확인할 수 있었다. Project Sight Span에서는 이미지를 기반으로 공간을 생성하고, 그 안을 이동하며 새로운 시점을 탐색할 수 있다.
원본 이미지에는 존재하지 않았던 앵글에서 구도를 검토하거나, 프레임 밖까지 시점을 확장하는 것도 가능하다. 한 장의 정지 이미지를 출발점으로 새로운 구도나 촬영 앵글을 검토할 수 있는 제작 환경을 목표로 한다.
Project Hands On
‘Project Hands On’은 이미지 내의 객체를 직접 조작하는 듯한 감각으로 편집하는 기술이다. 객체 분할 모델과 시각 언어 모델(VLM)을 활용하여 이미지 내용을 분석하고, 캔버스 상에 대상 객체를 조작하기 위한 컨트롤을 생성한다.
창작자는 이러한 컨트롤을 드래그하여 이미지 내 객체의 모양이나 크기 등을 직관적으로 변경할 수 있다. 복잡한 선택 조작이나 세밀한 파라미터 설정을 반복하는 대신, 이미지 내 요소를 직접 움직여 편집하는 새로운 인터페이스를 제안하는 연구다.
Project Rinse Repeat

‘Project Rinse Repeat’는 이미지 일부에 적용한 편집 조작을 다른 영역에도 확장하는 기술이다. 예를 들어, 특정 객체에 적용한 보정이나 가공 절차를 동일 이미지 내 다른 객체에도 적용할 수 있다. 이때 단순히 편집 결과를 복제하는 것이 아니라, 대상 영역의 모양이나 주변 상태에 맞춰 처리 내용을 조정한다.
특징적인 것은 편집 결과가 Adobe Photoshop의 네이티브 도구로 재현된다는 점이다. AI에 의한 처리 결과를 고정된 이미지로 출력하는 것이 아니라, 계속 편집 가능한 상태를 유지함으로써 창작자의 미세 조정이나 추가 수정에도 대응한다.
Project Link Up
이미지 내 객체를 직접 조작하는 연구를 벡터 디자인에 응용한 것이 ‘Project Link Up’이다. 예를 들어, 주차장을 그린 일러스트에 자동차 그래픽을 드래그하면, 배치되는 장면에 맞춰 자동차의 원근감, 크기, 스타일을 자동으로 조정한다.
단순히 객체를 이동시키는 것이 아니라, 드래그 조작에 포함된 창작자의 의도나 디자인 요소 간의 관계를 이해하여 배치를 조정하는 메커니즘이다. 편집 결과는 벡터 아트워크로 유지되므로, 이후에도 모양이나 배치를 변경할 수 있다. 직관적인 조작과 편집 가능한 디자인 데이터의 양립을 목표로 한다.
Adobe Labs Playground에서 연구 성과 일부 체험 가능
이번 Sneaks에서는 연구 성과를 소개하는 것뿐만 아니라, 일부 기술을 직접 조작할 수 있는 환경도 공개되었다. ‘Adobe Labs Playground’에서는 이번에 발표된 10건 중 ‘Project Deep Brush’와 ‘Project Hands On’ 두 건을 연구 프리뷰로 체험할 수 있다.
더불어 Photoshop용으로 연구 중인 ‘Project Custom Filters’도 프리뷰 공개되었다. Project Custom Filters는 Sneaks에서 발표된 10건에는 포함되지 않은 별도의 연구 프로젝트다.
Adobe Labs에서는 연구 개발 중인 기술과 창작 제작에 관한 지견을 공개하는 동시에, 사용자로부터 피드백을 받고 있다. 또한, Adobe Research의 연구 성과와 기술적 진전을 소개하는 정보원으로도 자리매김하고 있다.
이번에 소개된 10건은 모두 연구 단계 프로젝트이며, 정식 제품 탑재나 제공 시기가 확정된 것은 아니다. 한편, 여러 컷을 넘나드는 편집 내용 반영, 영상 내 이벤트 발생 시점 제어, 음성 추출·변형, 이미지 구조를 이해하는 직접 조작 등 각 프로젝트가 목표하는 방향성에는 공통점이 있다.
이는 AI에 제작을 일임하는 것이 아니라, 창작자가 무엇을 변경하고 싶은지를 보다 직접적인 조작으로 전달할 수 있는 환경을 만드는 생각이다. 이번 Adobe MAX Sneaks는 영상, 음성, 이미지, 디자인이라는 각기 다른 분야를 아우르면서, 창작자의 의도를 이해하고 편집의 자유도를 높이는 차세대 도구의 가능성을 보여주는 내용이 되었다.
관련 글
- Avid, AI 기반 편집 기능 ‘Ready to Play’ 출시
- 니콘, RED와 ‘Inter BEE 2026’ 참가…Z CINEMA 시리즈 영상 솔루션 공개
- 어도비, 크리에이티브 AI ‘Firefly’ 기능 강화…자연어 기반 워크플로우 지원